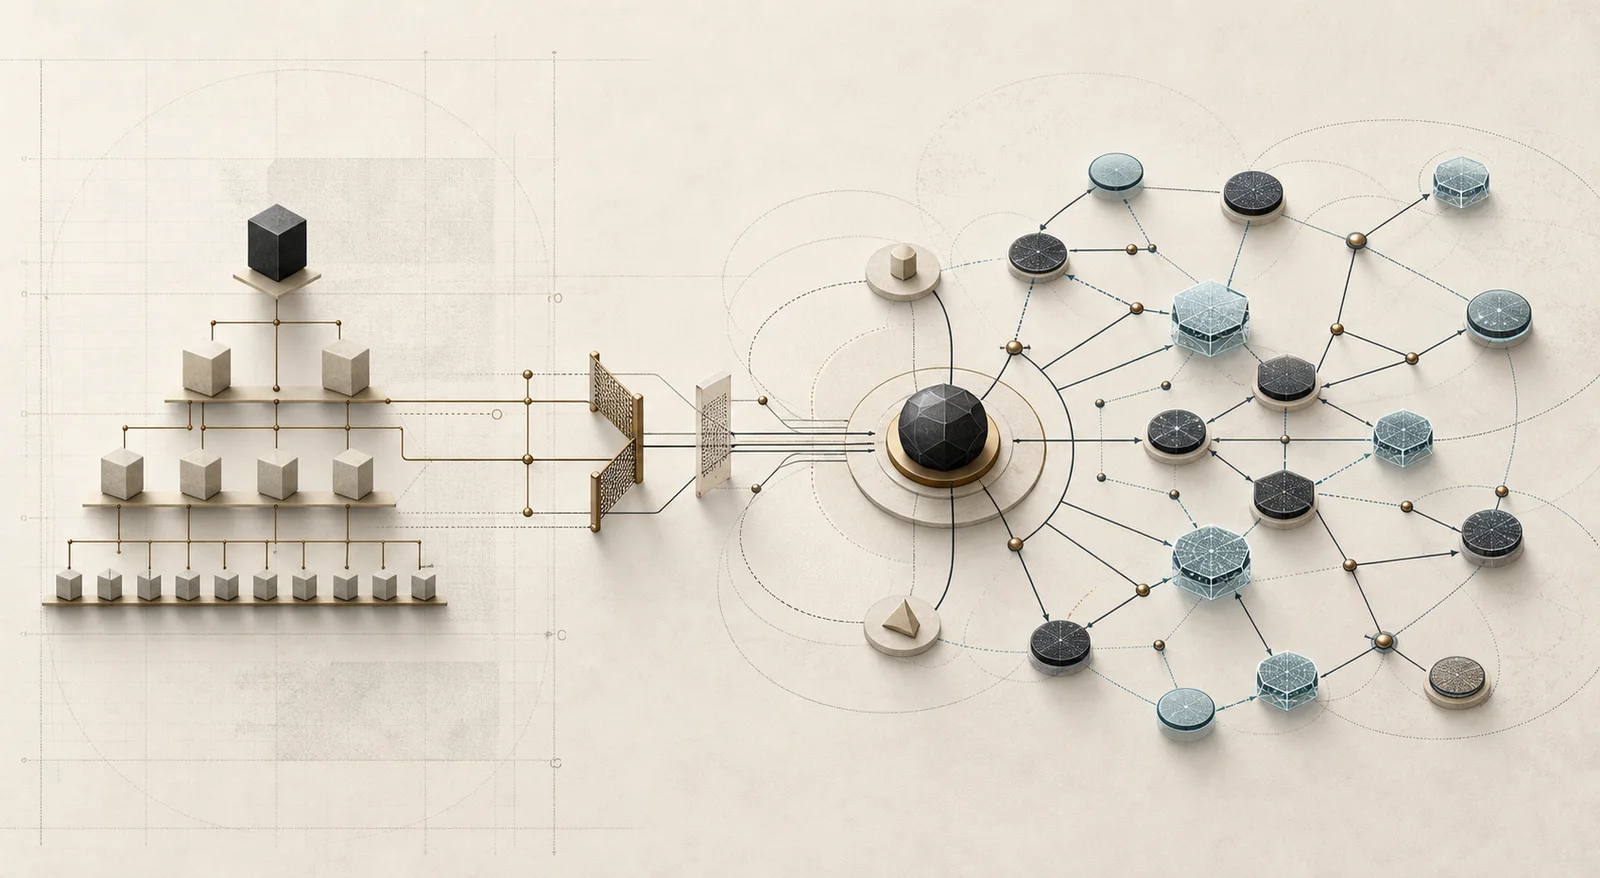
AI转型进入规模化后,一个组织设计问题很快出现:AI能力应该集中在中央团队,还是分散到业务单元?两个极端都很常见。全部集中,中央团队变成需求工厂;全部分散,各部门重复建设,安全和数据问题迅速增加。更可行的结构通常是混合模式。
适合中央化的能力具有规模经济
模型接入、身份权限、数据基础设施、监控、Evaluation框架和通用Agent能力,重复建设成本很高。这类能力更适合平台化。中央团队可以提供统一的“黄金路径”,让业务团队不需要每次从模型选型、安全接入开始重做。 数据分类、隐私、安全、法律和审计不能完全由各业务自行定义。治理的目标不应是把所有Use Case集中审批,而是建立一致护栏。
场景和工作流必须靠近业务
真正理解一个流程哪里浪费、哪里需要判断、哪里存在客户风险的人,通常在业务团队。如果所有场景都由中央AI专家设计,很容易得到技术上漂亮、使用上生硬的方案。业务团队应该拥有Outcome和Workflow。AI团队提供技术能力和方法,不能替业务定义价值。
中央平台和业务自治之间,还需要知识流动。AI Champion、实践社区、共享案例、组件市场和跨团队Review,可以让新经验快速扩散。尤其要识别能够判断AI质量、设计工作流和定义规则的人,而不只是最会用工具的人。
早期专家稀缺时,更集中比较合理。业务团队能力提高后,很多职责应该下放。中央团队如果长期承担所有项目,会成为规模化瓶颈。因此,AI Operating Model不是一次设计完毕。企业需要定期检查:哪些能力已经可以平台化,哪些应该回到业务,哪些新风险仍需中央管理。
组织边界不只看效率,还要看责任。如果某类AI错误主要由业务承担客户和合规后果,业务团队需要拥有更多规则定义权;如果风险具有全公司外溢性,中央治理就应该更强。这个标准可以帮助企业处理很多“中央还是业务”的争论。权力应该尽量靠近信息和责任,同时保留必要的企业级护栏。
中央平台承担模型调用和基础设施以后,业务团队容易觉得AI“免费”。如果成本完全不可见,场景会不断增加,也不利于判断ROI。可以让平台统一采购和治理,同时把使用成本透明到业务单元。这样,中央化带来规模经济,业务仍然对使用效率承担责任。
成本机制也是Operating Model的一部分。真正值得讨论的是如何让共享能力降低重复成本,同时让业务团队保留改变工作的速度;“谁拥有AI”只是组织分工的表象。
混合模式需要清楚的责任切片
“中央平台+业务团队”听起来合理,落地时却常出现双方都以为对方负责。可以把责任切成四层:
| 层级 | 主要责任 |
|---|---|
| 企业治理 | 风险分级、数据政策、审计要求、禁用边界 |
| 共享平台 | 模型接入、身份权限、监控、Evaluation工具、通用组件 |
| 领域能力 | 业务知识、数据语义、领域规则、可复用Agent或技能 |
| 场景团队 | Outcome、工作流重构、上线验证、采用与持续经营 |
企业治理和共享平台适合保持一致;领域能力与场景结果需要靠近业务。每一层都要有Owner、服务边界和升级路径,避免中央团队对结果没有业务权力,业务团队对系统又没有技术控制。
平台团队要经营产品,而不是接项目
中央团队最容易变成内部外包:业务提需求,AI团队排期交付,需求越多,瓶颈越严重。平台化的真正含义,是提供可自助使用的能力、清楚的服务等级、参考架构和可观察性,让业务团队能够在护栏内独立构建。平台的绩效也应从“完成多少AI项目”转向:接入周期是否下降,重复建设是否减少,安全默认值是否有效,业务团队能否自助解决常见问题,通用组件是否真实复用。
如果某项能力只服务一个场景、需要大量业务判断,就不应为了“统一”被强行平台化。平台应该吸收稳定共性,而非吞下所有差异。
业务自治必须伴随最低工程能力
把场景Owner放在业务,并不意味着任何团队都可以直接上线Agent。业务单元至少需要能够定义验收标准、维护Context、理解数据边界、运行评估和处理异常的人。当这些能力尚未形成,可以采用联合小队:业务Owner、领域专家、平台工程师和风险伙伴共同完成首批场景,同时把方法和资产留在业务。中央团队的任务是“帮助业务学会”,而非永久代做。
成熟度提高后,审批也可以从逐案审查转成风险分级。低风险场景沿黄金路径自助上线,高风险场景进入专项Review,重大外溢风险由企业治理保留否决权。
用架构测试,而不是组织口号做调整
每个季度可以检查四组信号:平台采用和复用、从想法到上线的时间、重大异常与合规事件、业务结果及运行成本。若中央队列持续增长,说明职责需要下放或平台自助性不足;若各业务重复采购和建设,说明共性能力没有被识别;若错误无法快速定位Owner,说明治理分层失效;若平台使用率很高但业务结果不清楚,说明组织只规模化了技术,没有规模化价值。
NIST AI RMF明确把治理视为贯穿Map、Measure和Manage的横向功能,并强调风险管理要结合具体场景、风险容忍度和资源。这种结构本身就支持混合模式:企业级治理提供共同语言,场景团队根据真实影响完成映射、测量和管理。
中央与业务的冲突,往往来自不同成功标准
中央平台通常追求安全、一致、复用和单位成本;业务团队关注场景速度、客户结果和本地适配。两边都可能正确,却在日常决策中互相阻碍。中央团队认为业务重复造轮子,业务团队认为平台永远排不上真正紧急的需求。
Operating Model需要把这些标准放到共同结果中。平台要承诺接入时间、可靠性、覆盖场景和自助率;业务团队要承诺Outcome、采用、Context质量、运行成本和异常处置。只有双方都对结果的一部分负责,讨论才会从“谁控制AI”转成“怎样降低端到端摩擦”。
还要建立明确的例外机制。业务若需要绕开标准路径,应说明价值窗口、额外风险、临时控制和回归平台的时间;平台若拒绝需求,应说明依据并提供替代路线。没有例外机制,团队要么被统一标准拖慢,要么通过影子工具绕开治理。
能力网络需要让经验双向流动
中央团队不仅向业务发布标准,也要持续吸收一线经验。领域团队发现的错误模式、评估样例和工作流组件,应进入共享资产;平台能力、治理变化和外部风险,也要通过实践社区、Champion和案例Review回到业务。
AI Champion不宜成为兼职客服或工具推广员。他应能够帮助团队定义问题、设计验证、识别风险,并把本地经验转成可复用知识。中央团队需要给Champion方法、时间和升级通道,业务Leader则要把这项责任放入正式工作。
从观点到管理动作
| 组织问题 | 中央责任 | 业务责任 | 共同机制 |
|---|---|---|---|
| 场景选择 | 提供方法和共性数据 | 定义价值、流程与Owner | 组合Review与停止清单 |
| 平台建设 | 黄金路径、权限、监控 | 提供真实需求与采用反馈 | 产品路线图和服务等级 |
| 风险治理 | 企业底线与分级规则 | 识别场景影响并处理异常 | 高风险Review和事故复盘 |
| 知识能力 | 通用框架与共享资产 | 维护领域Context和样例 | Champion网络与组件市场 |
| 成本 | 规模采购与透明计量 | 对场景用量和ROI负责 | Showback、预算和容量校准 |
第一次调整可以从中央队列里选择十个需求,判断哪些是真共性、哪些必须靠近业务、哪些其实没有清楚Outcome。把责任重新切片后运行一个季度,再看接入周期、复用、异常和业务结果。混合模式的成熟度不在组织图写了多少虚实线,而在中央能力与业务速度能否同时提高。
组织边界还要匹配技术架构
职责下放的前提,是平台已经把安全默认值、身份权限、日志和评估做成可复用接口。若技术架构高度耦合,任何业务改动都可能影响全公司,组织上的自治只会制造更多跨团队协调。反过来,平台即使技术成熟,若服务边界和Owner不清,业务仍会通过项目制获取能力。
Operating Model与平台架构需要共同演进。中央团队把稳定共性封装成产品,领域团队对语义和规则负责,场景团队在清楚接口上组合能力。每次组织争议都可以反问:这是权责不清,还是技术耦合迫使所有决定集中?两类问题需要不同解法。
高层必须解决共享优先级
中央平台服务多个业务时,最难的往往是谁的需求优先。若缺少企业级组合选择,平台负责人只能根据声音、关系和临时升级排队,最终失去路线图。管理层需要定期比较共性价值、业务窗口、风险和复用,明确少数企业级能力及暂停项。业务也要为紧急需求承担机会成本。只有优先级成为共同经营决定,平台才可能摆脱“所有客户都重要”的内部外包困境。
成本透明度可以辅助这种选择,但不能由调用费用单独决定。高风险控制、基础数据和评估平台短期可能没有直接收入,却是多个场景的前置条件。组合评审需要同时看业务收益、风险降低和未来选项。
延伸依据:NIST AI RMF Core、NIST Generative AI Profile、OECD:AI and skills